บทความที่เกี่ยวข้อง
สรุปให้เร็ว
Google Bot คือซอฟต์แวร์อัตโนมัติที่ทำหน้าที่ค้นหา อ่าน และจัดเก็บข้อมูลเว็บไซต์ทั่วโลกเข้าสู่ Google Index ในปี 2026 Google Bot ไม่ได้แค่เก็บข้อความ แต่ทำงานร่วมกับ AI อย่าง Gemini เพื่อเข้าใจ “ความหมาย” ของเนื้อหา ถ้าเว็บคุณพร้อมทั้งด้าน Technical, Content และ Structure โอกาสถูก AI หยิบไปตอบคำถามจะสูงขึ้นอย่างมาก บทความนี้จะพาดูทุกอย่างตั้งแต่กลไกการทำงาน, User Agents ทั้งหมด, วิธีตรวจสอบ และเทคนิคปรับเว็บให้บอทรัก
Google Bot คืออะไร (ฉบับอัปเดตปี 2026)
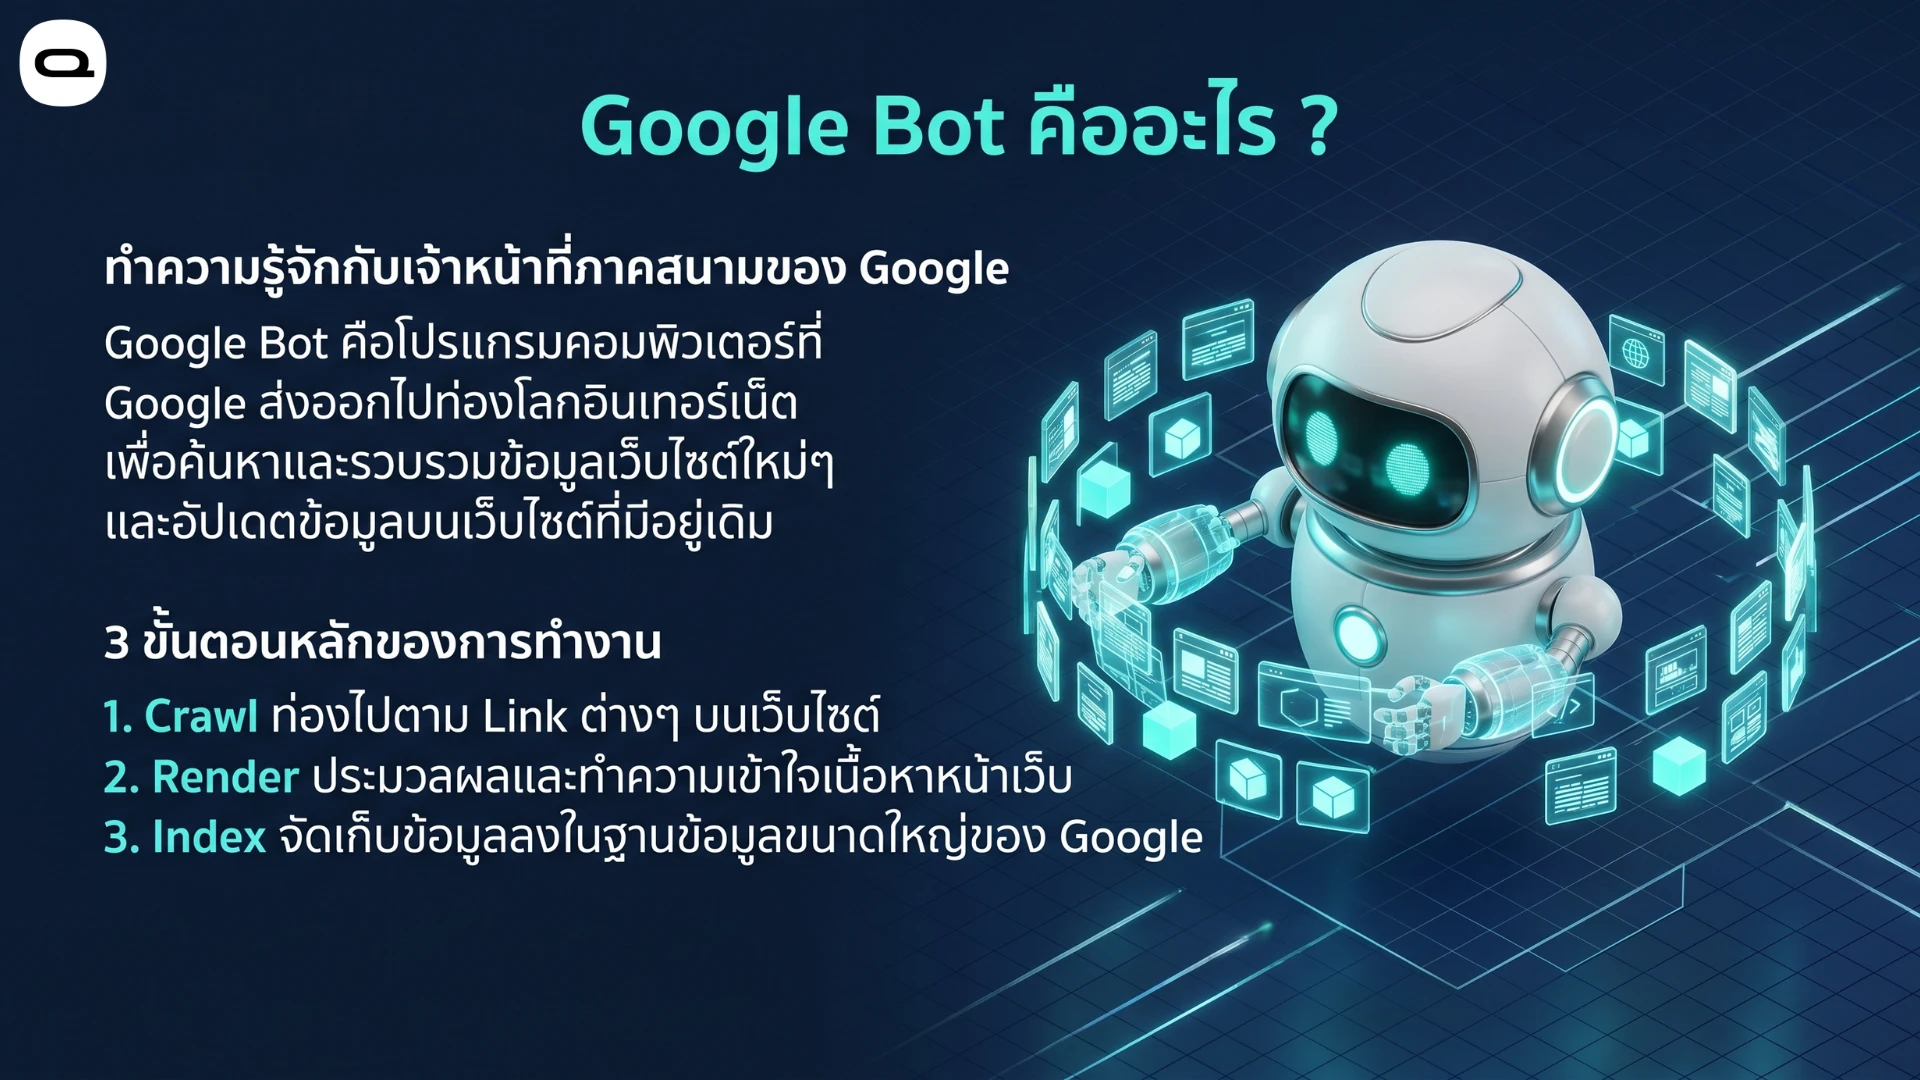
Google Bot (หรือที่คนในวงการเรียกว่า Spider หรือ Crawler) คือซอฟต์แวร์หุ่นยนต์อัตโนมัติของ Google ที่ทำงานตลอด 24 ชั่วโมงทุกวัน ภารกิจหลักของมันคือการท่องโลกอินเทอร์เน็ตเพื่อ ค้นหา (Crawl), อ่าน (Render) และ จัดเก็บข้อมูล (Index) เว็บไซต์นับล้านล้านหน้า แล้วนำข้อมูลทั้งหมดกลับไปเก็บในคลังข้อมูลขนาดมหึมาที่เรียกว่า Google Index
เปรียบเทียบแบบเห็นภาพ ถ้า Search Engine อย่าง Google คือห้องสมุดที่ใหญ่ที่สุดในจักรวาล และ AI อย่าง Gemini คือบรรณารักษ์อัจฉริยะ Google Bot ก็คือ “เจ้าหน้าที่ภาคสนาม” ที่ออกวิ่งเก็บหนังสือ นิตยสาร วิดีโอ และสื่อทุกประเภทจากทั่วทุกมุมโลก กลับมาส่งเข้าห้องสมุด ถ้าเจ้าหน้าที่คนนี้ไม่เจอหนังสือของคุณ ก็ไม่มีทางที่บรรณารักษ์ (AI) จะหยิบเรื่องของคุณไปเล่าให้คนอื่นฟังได้เลย
แต่ในปี 2026 Google Bot เปลี่ยนไปจากเมื่อก่อนมาก มันไม่ได้แค่ “เก็บข้อความ” แบบเครื่องจักรอีกต่อไป แต่มันเข้าใจความหมาย บริบท และความสัมพันธ์ระหว่างข้อมูล เพื่อส่งต่อให้ AI สร้างคำตอบที่แม่นยำที่สุดให้ผู้ใช้ นี่คือเหตุผลที่คนทำเว็บในยุคนี้ต้องเข้าใจ Google Bot อย่างลึกซึ้ง ไม่ใช่แค่รู้ว่ามันคืออะไร แต่ต้องรู้ว่ามัน “คิด” อย่างไร
ทำไม Google Bot ถึงสำคัญกว่าที่คิด
หลานหลายคนอาจสงสัยว่า ทำไมต้องมานั่งศึกษาเรื่องบอทด้วย แค่เขียนเนื้อหาดี ๆ ไม่พอหรือ? คำตอบสั้น ๆ คือ “ไม่พอ” และนี่คือเหตุผลที่พ่อใหญ่อยากให้เข้าใจ
1. ถ้าบอทเข้าไม่ได้ ทุกอย่างจบ ไม่ว่าเนื้อหาจะดีแค่ไหน ถ้า Google Bot เข้าเว็บคุณไม่ได้หรือ Render หน้าเว็บไม่สำเร็จ เนื้อหานั้นก็ “ไม่มีอยู่” ในสายตาของ Google ลองนึกภาพว่าคุณเขียนหนังสือเล่มเยี่ยมแต่เก็บไว้ในห้องที่ล็อกกุญแจ ไม่มีใครได้อ่านก็เหมือนไม่เคยเขียน
2. AI Search เปลี่ยนเกมทั้งหมด ในอดีต Google Bot แค่เก็บข้อมูลไปแสดงผลเป็น 10 Blue Links บนหน้า SERP แต่ตอนนี้ข้อมูลที่บอทเก็บถูกนำไปป้อนให้ Google Algorithm และ AI Model อย่าง Gemini เพื่อสร้างคำตอบใน AI Overviews โดยตรง ถ้าเว็บคุณไม่ถูกเก็บอย่างครบถ้วน AI ก็ไม่มีข้อมูลจะดึงไปอ้างอิง
3. Crawl Budget มีจำกัด Google ไม่ได้ส่งบอทมาเก็บทุกหน้าของเว็บคุณทุกวัน มันมีสิ่งที่เรียกว่า Crawl Budget ซึ่งเป็น “โควตา” ที่บอทจะใช้กับเว็บแต่ละเว็บ ถ้าเว็บคุณมีปัญหาเชิง Technical SEO มากเกินไป บอทจะเสียเวลากับหน้าที่ไม่สำคัญ แล้วหน้าสำคัญกลับไม่ได้เก็บ
4. ส่งผลต่อทุก SEO Metrics ที่คุณวัด ตั้งแต่ Organic Traffic, Impressions, Click-Through Rate ไปจนถึง Revenue ทุกตัวชี้วัดเริ่มต้นจากจุดเดียวกัน นั่นคือการที่ Google Bot ค้นพบและเข้าใจเว็บไซต์ของคุณ ถ้าจุดเริ่มต้นนี้พัง ทุกอย่างที่ตามมาก็พังตามไปด้วย
กระบวนการทำงานของ Google Bot 2026 แบบเจาะลึก
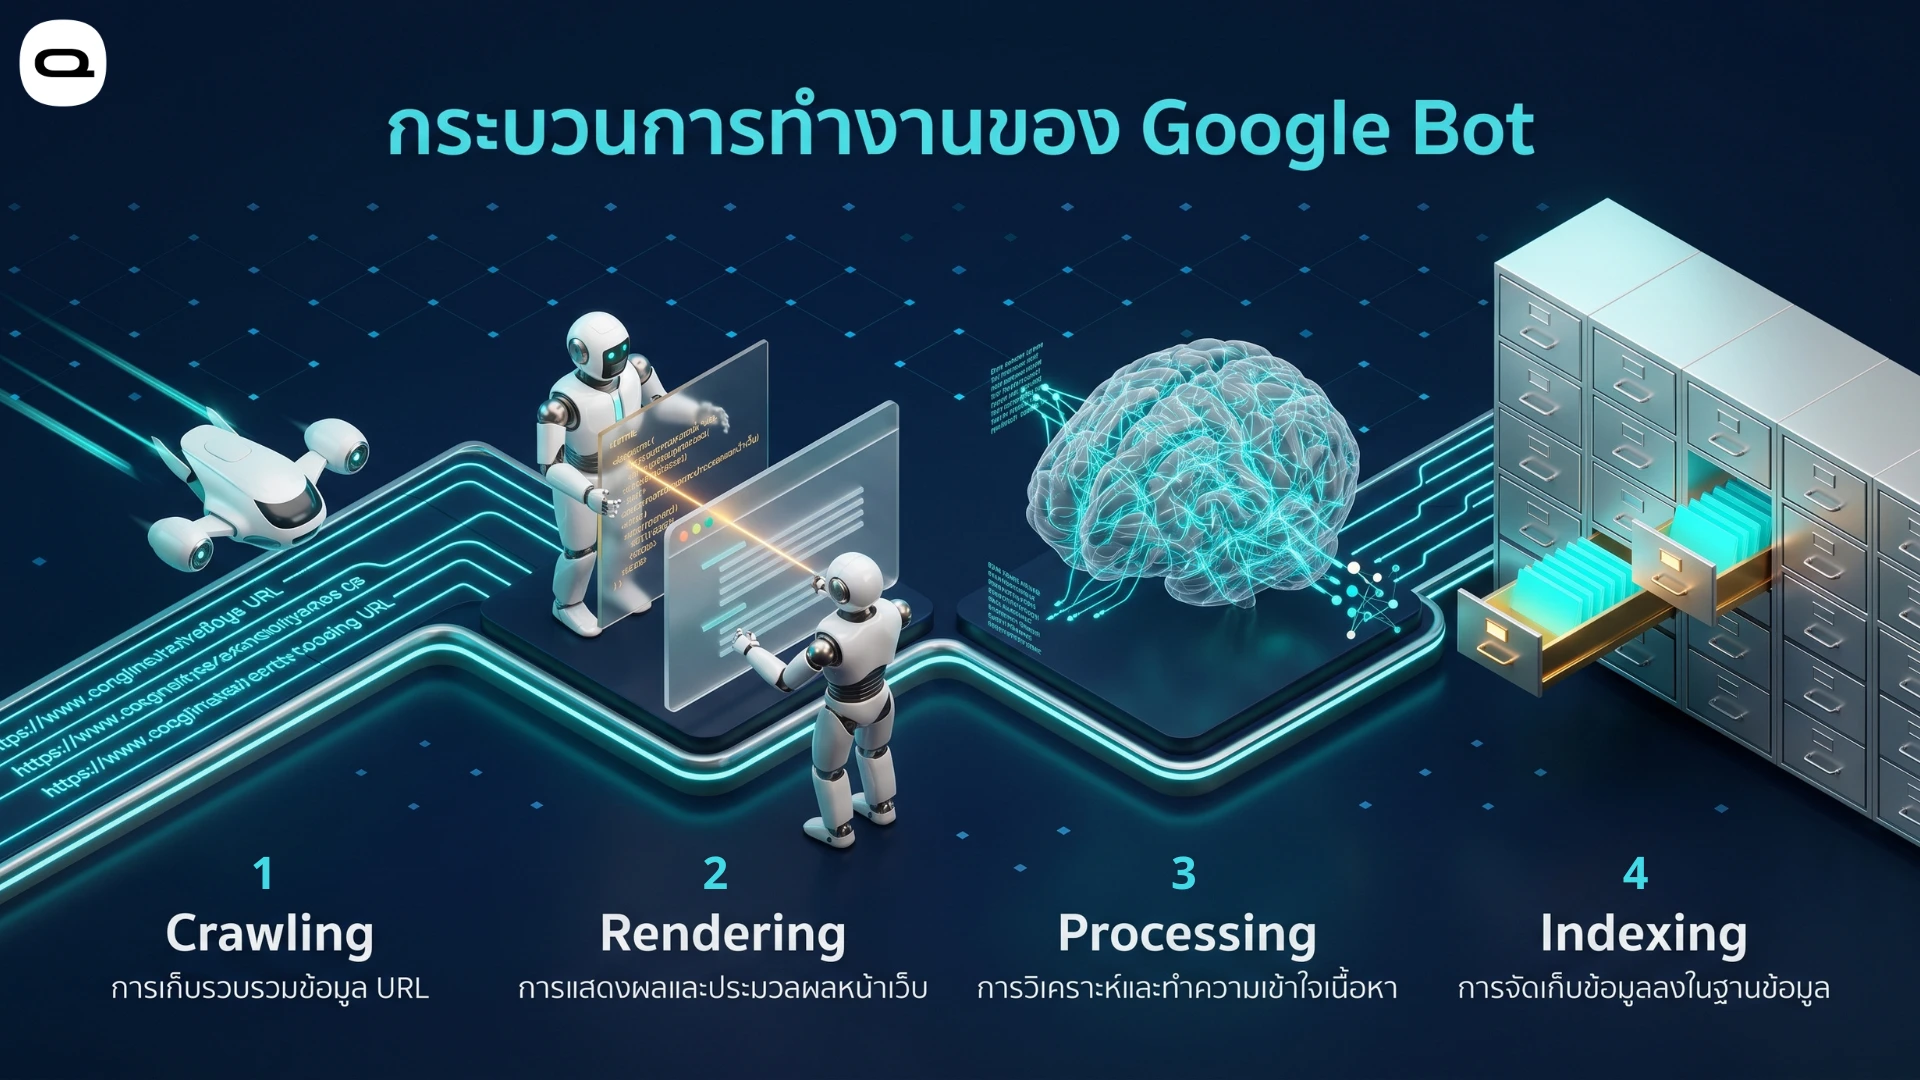
ในปี 2026 กระบวนการทำงานของ Google Bot ไม่ได้จบแค่การเก็บ Text ธรรมดาอีกต่อไป แต่มีขั้นตอนที่ซับซ้อนขึ้นมากเพื่อรองรับ AI Overviews และ Generative Search พ่อใหญ่จะพาเจาะทีละขั้นตอนครับ
ขั้นตอนที่ 1 Crawling (การค้นพบเส้นทาง)
Google Bot เริ่มต้นจากการตามหา URL ใหม่ ๆ มันจะเดินทางผ่าน Links (ลิงก์) จากหน้าหนึ่งไปอีกหน้าหนึ่ง หรืออ่านจาก XML Sitemap (แผนผังเว็บไซต์) ที่เจ้าของเว็บส่งมาให้
สิ่งที่เปลี่ยนไปในปี 2026 บอททำงานเร็วขึ้นและฉลาดในการจัดลำดับความสำคัญ (Prioritization) มากกว่าเดิม มันจะวิ่งเข้าหาเนื้อหาที่มีความสดใหม่ (Freshness) และเว็บที่มี Ranking Factors ด้านความน่าเชื่อถือสูง (High Authority) ก่อนเสมอ ในทางกลับกัน เว็บที่มีโครงสร้างห่วยหรือมีลิงก์เสีย (Broken Links) จำนวนมาก จะถูกบอทจัดลำดับต่ำลง
ปัจจัยที่มีผลต่อการ Crawl ได้แก่ ความถี่ในการอัปเดตเนื้อหา, ความสำคัญของหน้า (จากจำนวน Internal Links ที่ชี้มา), ขนาดของเว็บไซต์ และประวัติการตอบสนองของ Server ถ้า Server ตอบช้าหรือ Error บ่อย บอทจะลดความถี่ในการเข้ามาโดยอัตโนมัติ
ขั้นตอนที่ 2 Rendering (การประมวลผลหน้าเว็บ)
นี่คือขั้นตอนที่สำคัญที่สุดในยุคปัจจุบัน และเป็นจุดที่เว็บไซต์จำนวนมากพลาด Google Bot ปี 2026 ทำงานเหมือนเบราว์เซอร์ Chrome บนมือถือแทบจะ 100% มันจะรัน JavaScript ทั้งหมดเพื่อดูว่าหน้าเว็บมีหน้าตาเป็นอย่างไรเมื่อโหลดเสร็จสมบูรณ์
กระบวนการ Rendering ที่บอททำได้แก่
- รัน JavaScript เพื่อสร้าง DOM (Document Object Model) ฉบับสมบูรณ์
- วัดค่า Page Speed และ Core Web Vitals ทันที (LCP, INP, CLS)
- ถ่ายภาพหน้าจอ (Screenshot) เพื่อวิเคราะห์ Layout และ UX
- ตรวจสอบว่าเนื้อหาที่ผู้ใช้เห็นตรงกับ HTML ที่ Server ส่งมาหรือไม่ (Cloaking Detection)
สิ่งที่ต้องระวังคือ หากเว็บคุณใช้ JavaScript Framework หนัก ๆ อย่าง React หรือ Vue แล้วไม่ได้ทำ Server-Side Rendering (SSR) บอทอาจต้อง “รอ” นานกว่าจะเห็นเนื้อหาครบ ถ้ารอนานเกินไป มันอาจจะถอดใจและออกจากเว็บไปก่อนที่จะได้ข้อมูลทั้งหมด นั่นหมายความว่าเนื้อหาบางส่วนของคุณอาจไม่ถูก Index
ขั้นตอนที่ 3 Processing and Extraction (การถอดรหัสเพื่อ AI)
ในอดีต ขั้นตอนนี้คือการดู Keyword ว่าหน้านี้เกี่ยวกับอะไร แต่ในปี 2026 Google Bot ทำงานร่วมกับ AI Model เพื่อแปลงเนื้อหาของคุณให้อยู่ในรูปแบบที่ AI เข้าใจได้
Text to Vectors บอทจะแปลงข้อความให้เป็นภาษาคณิตศาสตร์ (Embeddings) เพื่อให้ AI เข้าใจ “ความหมายแฝง” และ “บริบท” ของเนื้อหา ไม่ใช่แค่จับคู่คำค้นหาแบบตรงตัวอีกต่อไป ยกตัวอย่างเช่น ถ้าคุณเขียนเรื่อง “วิธีเพิ่มยอดขายออนไลน์” บอทจะเข้าใจว่ามันเกี่ยวข้องกับ E-commerce, Digital Marketing และ Conversion Optimization ด้วย แม้คุณไม่ได้เขียนคำเหล่านั้นตรง ๆ
Entity Recognition บอทไม่ได้มองคำว่า “Apple” เป็นแค่ตัวอักษรอีกต่อไป แต่มองเป็น Entity (สิ่งของ/ตัวตน) ว่าหมายถึงผลไม้หรือบริษัทเทคโนโลยี โดยวิเคราะห์จากบริบทรอบข้าง การทำ Schema Markup จะช่วยให้บอทเข้าใจ Entity ได้แม่นยำขึ้น เพราะคุณ “บอกตรง ๆ” ว่าข้อมูลนี้คืออะไร
Media Understanding Google Bot ในปี 2026 พยายามทำความเข้าใจรูปภาพและวิดีโอ (Multimodal Understanding) ว่าเกี่ยวกับเรื่องอะไร เพื่อนำไปแสดงในผลการค้นหาแบบ Visual และใน AI Overviews ดังนั้นการทำ Image SEO ให้ถูกต้อง ทั้ง Alt Text, File Name และ Structured Data จึงสำคัญมากกว่าที่เคย
Semantic Relationship Mapping บอทจะวิเคราะห์ว่าหน้าเว็บนี้มีความสัมพันธ์กับหน้าอื่น ๆ อย่างไร ทั้งภายในเว็บเดียวกัน (Content Hubs) และกับเว็บภายนอก ยิ่งเนื้อหาของคุณเชื่อมโยงกันเป็นระบบมากเท่าไร AI ก็ยิ่งเข้าใจว่าเว็บคุณ “เชี่ยวชาญ” เรื่องนั้นจริง ๆ
ขั้นตอนที่ 4 Indexing (การจัดเก็บเข้าคลัง)
เมื่อผ่านทุกด่านเรียบร้อย ข้อมูลจะถูกบันทึกเข้า Google Index พร้อมระบุว่าหน้านี้เกี่ยวกับอะไร ตอบคำถามเรื่องไหนได้ดีที่สุด มีความน่าเชื่อถือระดับไหน และเหมาะจะแสดงผลในรูปแบบใด (Text, Image, Video, Featured Snippets)
จุดที่ต้องรู้คือ ไม่ใช่ทุกหน้าที่ถูก Crawl จะถูก Index เสมอไป ถ้า Google Bot ตัดสินว่าเนื้อหาของคุณ “ไม่มีคุณค่าเพียงพอ” หรือซ้ำกับหน้าอื่น (Duplicate Content) มันจะเลือกไม่จัดเก็บ ปัญหา “Crawled – Currently Not Indexed” ที่หลายคนเจอใน Google Search Console ก็เกิดจากสาเหตุนี้
ระบบ Crawl Budget ที่คนทำเว็บต้องเข้าใจ
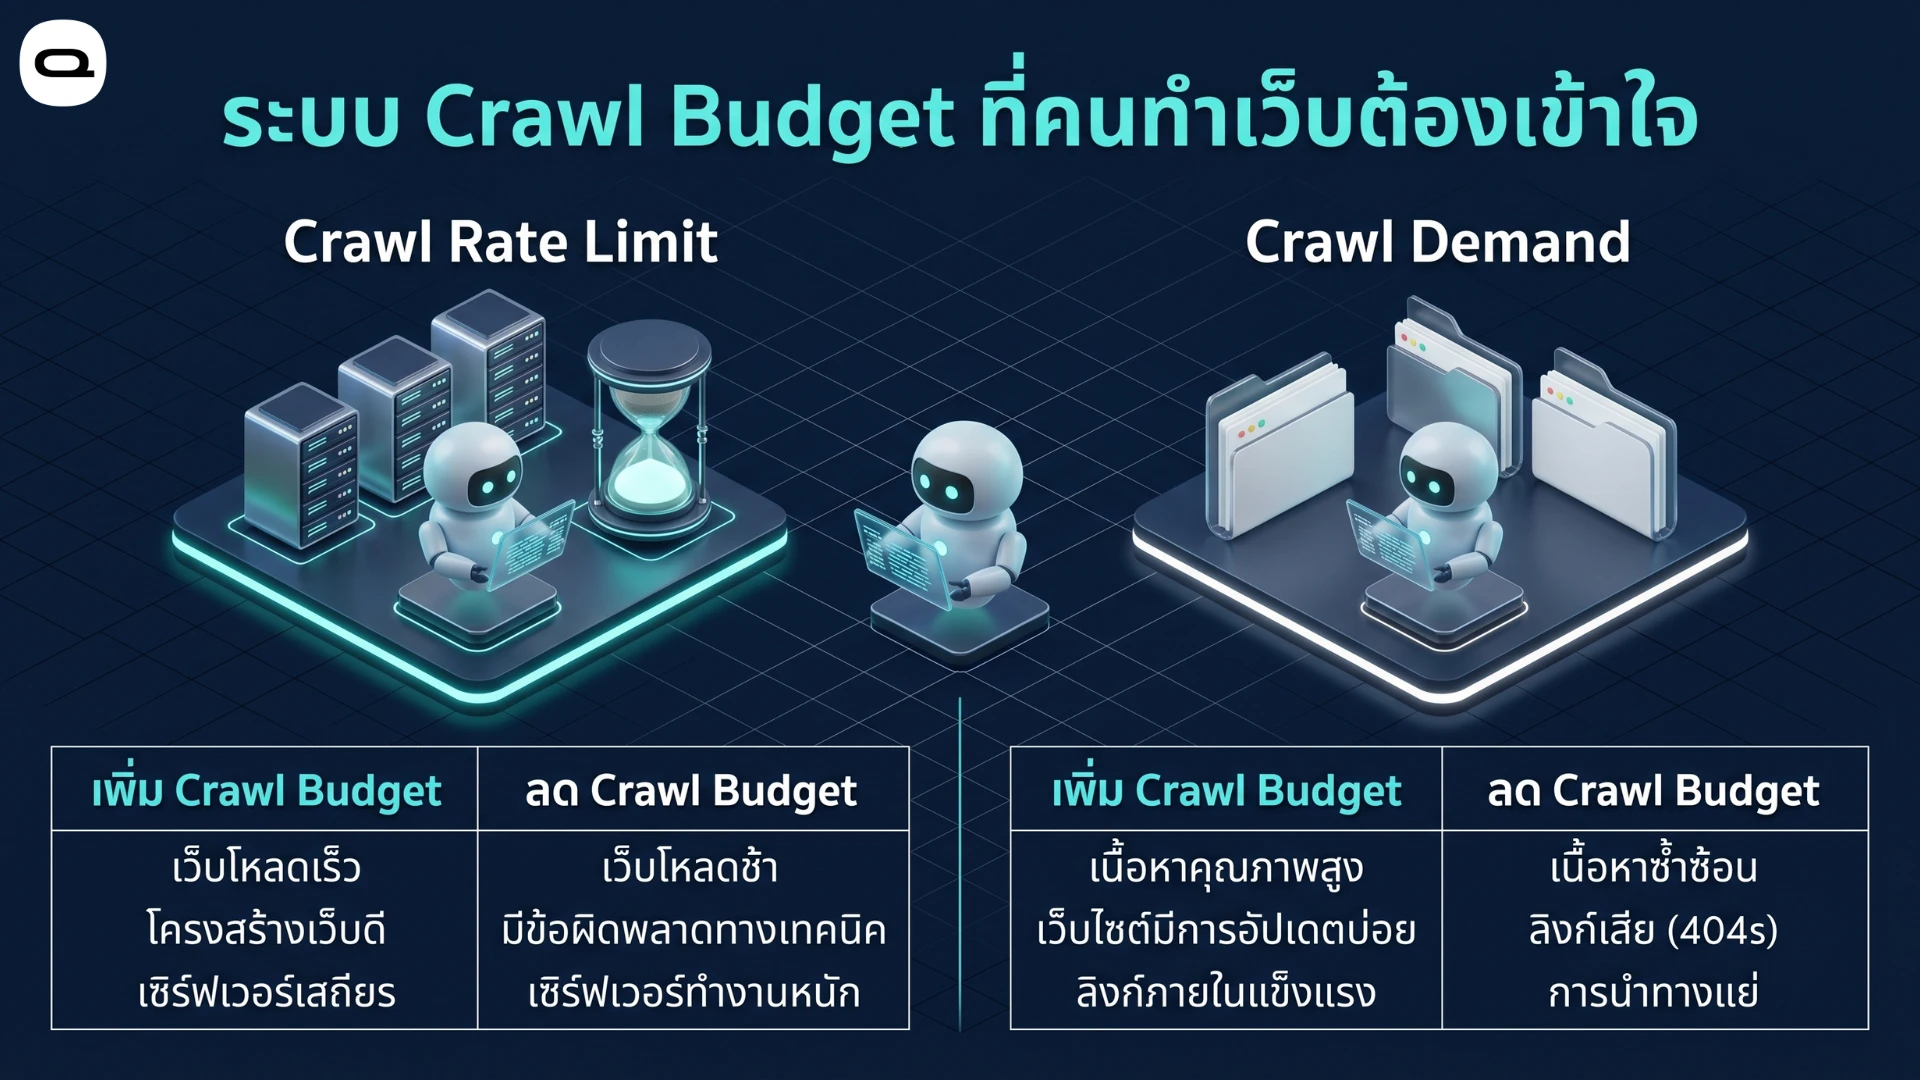
Crawl Budget คือ “โควตา” ที่ Google จัดสรรให้บอทใช้กับเว็บไซต์แต่ละแห่ง ประกอบด้วย 2 องค์ประกอบหลัก
Crawl Rate Limit คือจำนวนคำขอ (Requests) สูงสุดที่บอทจะส่งไปยัง Server ของคุณในช่วงเวลาหนึ่ง Google จะปรับค่านี้โดยอัตโนมัติตามความสามารถของ Server ถ้า Server ตอบเร็ว บอทจะเพิ่มความถี่ ถ้า Server ตอบช้าหรือ Error บ่อย บอทจะลดความถี่ลง
Crawl Demand คือระดับความต้องการของ Google ที่จะเก็บข้อมูลเว็บคุณ ถ้าเว็บคุณมีเนื้อหาที่คนค้นหาเยอะ มีลิงก์จากเว็บอื่นชี้มามาก และมีการอัปเดตบ่อย Crawl Demand จะสูง บอทจะมาบ่อยขึ้น
| ปัจจัย | เพิ่ม Crawl Budget | ลด Crawl Budget |
|---|---|---|
| Server Response | ตอบเร็วต่ำกว่า 200ms | ตอบช้า, Error 5xx บ่อย |
| Content Freshness | อัปเดตเนื้อหาสม่ำเสมอ | เนื้อหาเก่าไม่เคยอัปเดต |
| Site Authority | มี Backlinks คุณภาพสูง | ไม่มีลิงก์จากเว็บอื่นเลย |
| URL Structure | URL สะอาด จัดหมวดชัดเจน | URL ยาว มี Parameter ซ้ำซ้อน |
| Duplicate Content | ใช้ Canonical Tags ถูกต้อง | มีหน้าซ้ำเยอะ ไม่จัดการ |
สำหรับเว็บขนาดเล็ก (ต่ำกว่า 1,000 หน้า) Crawl Budget มักไม่ใช่ปัญหาใหญ่ แต่สำหรับเว็บ E-commerce หรือเว็บข่าวที่มีหลายหมื่นหลายแสนหน้า การบริหาร Crawl Budget คือหัวใจของ Technical SEO เลยทีเดียว
รายชื่อ Google Bot (User Agents) ฉบับครบถ้วนปี 2026
ในปี 2026 Google มีบอทหลายตัวที่ทำหน้าที่เฉพาะทาง พ่อใหญ่สรุปตัวหลัก ๆ ที่คุณจะเห็นใน Server Logs มาให้ครบแล้วครับ
| ชื่อ User Agent | หน้าที่หลัก | ความสำคัญ |
|---|---|---|
| Googlebot (Smartphone) | บอทหลักที่ใช้ Crawl และ Index เว็บทั่วโลก Google ใช้ Mobile-First Indexing 100% ตัวนี้จึงสำคัญที่สุด | สูงสุด |
| Googlebot (Desktop) | ใช้ตรวจสอบความเข้ากันได้ในจอคอมพิวเตอร์ และงานเฉพาะกิจบางอย่าง | ปานกลาง |
| GoogleOther | บอทที่เริ่มเห็นบ่อยขึ้นมาก ใช้สำหรับงาน R&D และการเทรน AI ภายในของ Google โดยเฉพาะ | สูง |
| Google-Extended | เก็บข้อมูลเพื่อปรับปรุง AI อย่าง Gemini โดยเฉพาะ สามารถเลือกบล็อกได้โดยไม่กระทบ Indexing ปกติ | สูง |
| Googlebot-Image | เก็บรูปภาพเข้า Google Images ถ้าบล็อกตัวนี้ รูปภาพจะไม่แสดงในผลการค้นหา | สูง |
| Googlebot-Video | เก็บวิดีโอสำหรับ Google Video Search และ Video Snippets | ปานกลาง |
| Googlebot-News | เก็บข่าวสำหรับ Google News และ Google Discover (เฉพาะเว็บข่าวที่ได้รับอนุมัติ) | สูง (เว็บข่าว) |
| AdsBot-Google | ตรวจสอบคุณภาพ Landing Page สำหรับ Google Ads (ไม่เกี่ยวกับ Organic Search) | สูง (ถ้าทำ Ads) |
สิ่งสำคัญที่ต้องจำคือ Googlebot (Smartphone) เป็นบอทหลักที่ใช้ตัดสินทุกอย่าง เพราะ Google ใช้ Mobile-First Indexing มาตั้งแต่ปี 2023 อย่างเต็มรูปแบบ นั่นหมายความว่า “เวอร์ชันมือถือ” ของเว็บคุณคือเวอร์ชันที่ Google ใช้เป็นหลักในการจัดอันดับ ถ้าเว็บคุณดีบน Desktop แต่ห่วยบน Mobile ก็เตรียมร่วงได้เลย
Google Bot กับ AI Search ในปี 2026
นี่คือส่วนที่เปลี่ยนแปลงมากที่สุดและส่งผลกระทบต่อ SEO ทั้งระบบ ในอดีต Google Bot เก็บข้อมูลมาแสดงผลเป็น 10 Blue Links บนหน้า SERP แต่ตอนนี้ข้อมูลที่บอทเก็บถูกนำไปใช้ในหลายรูปแบบ
AI Overviews (เดิมชื่อ SGE) Google ใช้ข้อมูลจาก Index มาสร้างคำตอบสรุปที่แสดงอยู่ด้านบนสุดของผลการค้นหา AI จะดึงข้อมูลจากหลายแหล่งมาประมวลผลเป็นคำตอบเดียว ถ้าเว็บคุณถูก Index อย่างครบถ้วนและมีเนื้อหาที่ชัดเจน โอกาสที่ AI จะหยิบเนื้อหาของคุณไปแสดงใน AI Overviews ก็สูงขึ้น
Gemini Integration Google ผสาน AI อย่าง Gemini เข้ากับระบบค้นหาอย่างลึกซึ้ง ข้อมูลที่ Google Bot เก็บจะถูกแปลงเป็น Embeddings ที่ Gemini เข้าใจได้ นั่นหมายความว่าการเขียนเนื้อหาแบบเก่าที่ “ยัดคำค้นหา” (Keyword Stuffing) ไม่ได้ผลอีกต่อไป เพราะ AI เข้าใจความหมายจริง ๆ ไม่ใช่แค่นับคำ
GoogleOther และ Google-Extended บอท 2 ตัวนี้มีบทบาทเพิ่มมากขึ้นในปี 2026 GoogleOther ใช้เก็บข้อมูลเพื่องานวิจัยและพัฒนา AI ภายใน ส่วน Google-Extended ใช้เก็บข้อมูลเพื่อปรับปรุง Gemini โดยเฉพาะ จุดที่น่าสนใจคือคุณสามารถเลือกบล็อก Google-Extended ใน Robots.txt ได้โดยไม่กระทบ Indexing ปกติ แต่ถ้าคุณอยากให้ AI “รู้จัก” แบรนด์คุณ การเปิดให้บอทเหล่านี้เข้าถึงก็เป็นกลยุทธ์ที่ควรพิจารณา
ผลกระทบต่อ SEO สิ่งที่คนทำเว็บต้องปรับตัวคือ เนื้อหาต้องถูกเขียนให้ “AI เข้าใจง่าย” ด้วย ไม่ใช่แค่คนอ่านรู้เรื่อง เทคนิคที่พ่อใหญ่แนะนำคือการเขียนแบบ Inverted Pyramid (ปิรามิดหัวกลับ) คือเอาคำตอบสรุปขึ้นมาก่อน แล้วค่อยขยายรายละเอียดทีหลัง นอกจากนี้การจัดโครงสร้างเนื้อหาด้วย Headings (H1-H6) ที่ชัดเจนจะช่วยให้ทั้งบอทและ AI ดึงข้อมูลไปใช้ได้ง่ายขึ้นมาก
Robots.txt และการควบคุม Google Bot
Robots.txt คือไฟล์ข้อความเล็ก ๆ ที่วางไว้ที่ root ของเว็บไซต์ ทำหน้าที่เป็น “ยาม” หน้าประตูบอกบอทว่า ห้ามเข้าตรงไหน และ เข้าได้ตรงไหน ถ้าตั้งค่าผิด อาจทำให้ Google Bot เข้าถึงหน้าสำคัญไม่ได้ หรือเข้าถึงหน้าที่ไม่ควรเห็น
User-agent: *
Allow: /
Disallow: /wp-admin/
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/

# AI Crawlers
User-agent: GPTBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: ClaudeBot
Allow: /

# Sitemap
Sitemap: https://example.com/sitemap.xml
จุดสำคัญที่ต้องระวังคือ อย่าเผลอเขียน Disallow: / (ห้ามเข้าทุกหน้า) โดยเด็ดขาด นี่คือข้อผิดพลาดที่พ่อใหญ่เห็นบ่อยมากในเว็บที่เพิ่งย้าย Server หรือเพิ่งปรับปรุงเว็บ นอกจากนี้ในปี 2026 การเปิดให้ AI Crawlers อย่าง GPTBot, ClaudeBot และ PerplexityBot เข้าถึงเว็บของคุณได้ก็เป็นกลยุทธ์สำคัญ เพราะจะช่วยเพิ่มโอกาสให้แบรนด์คุณถูกอ้างอิงใน AI Search Platforms อื่น ๆ นอกเหนือจาก Google
เทคนิคปรับเว็บให้ Google Bot รัก (และ AI ชอบ)
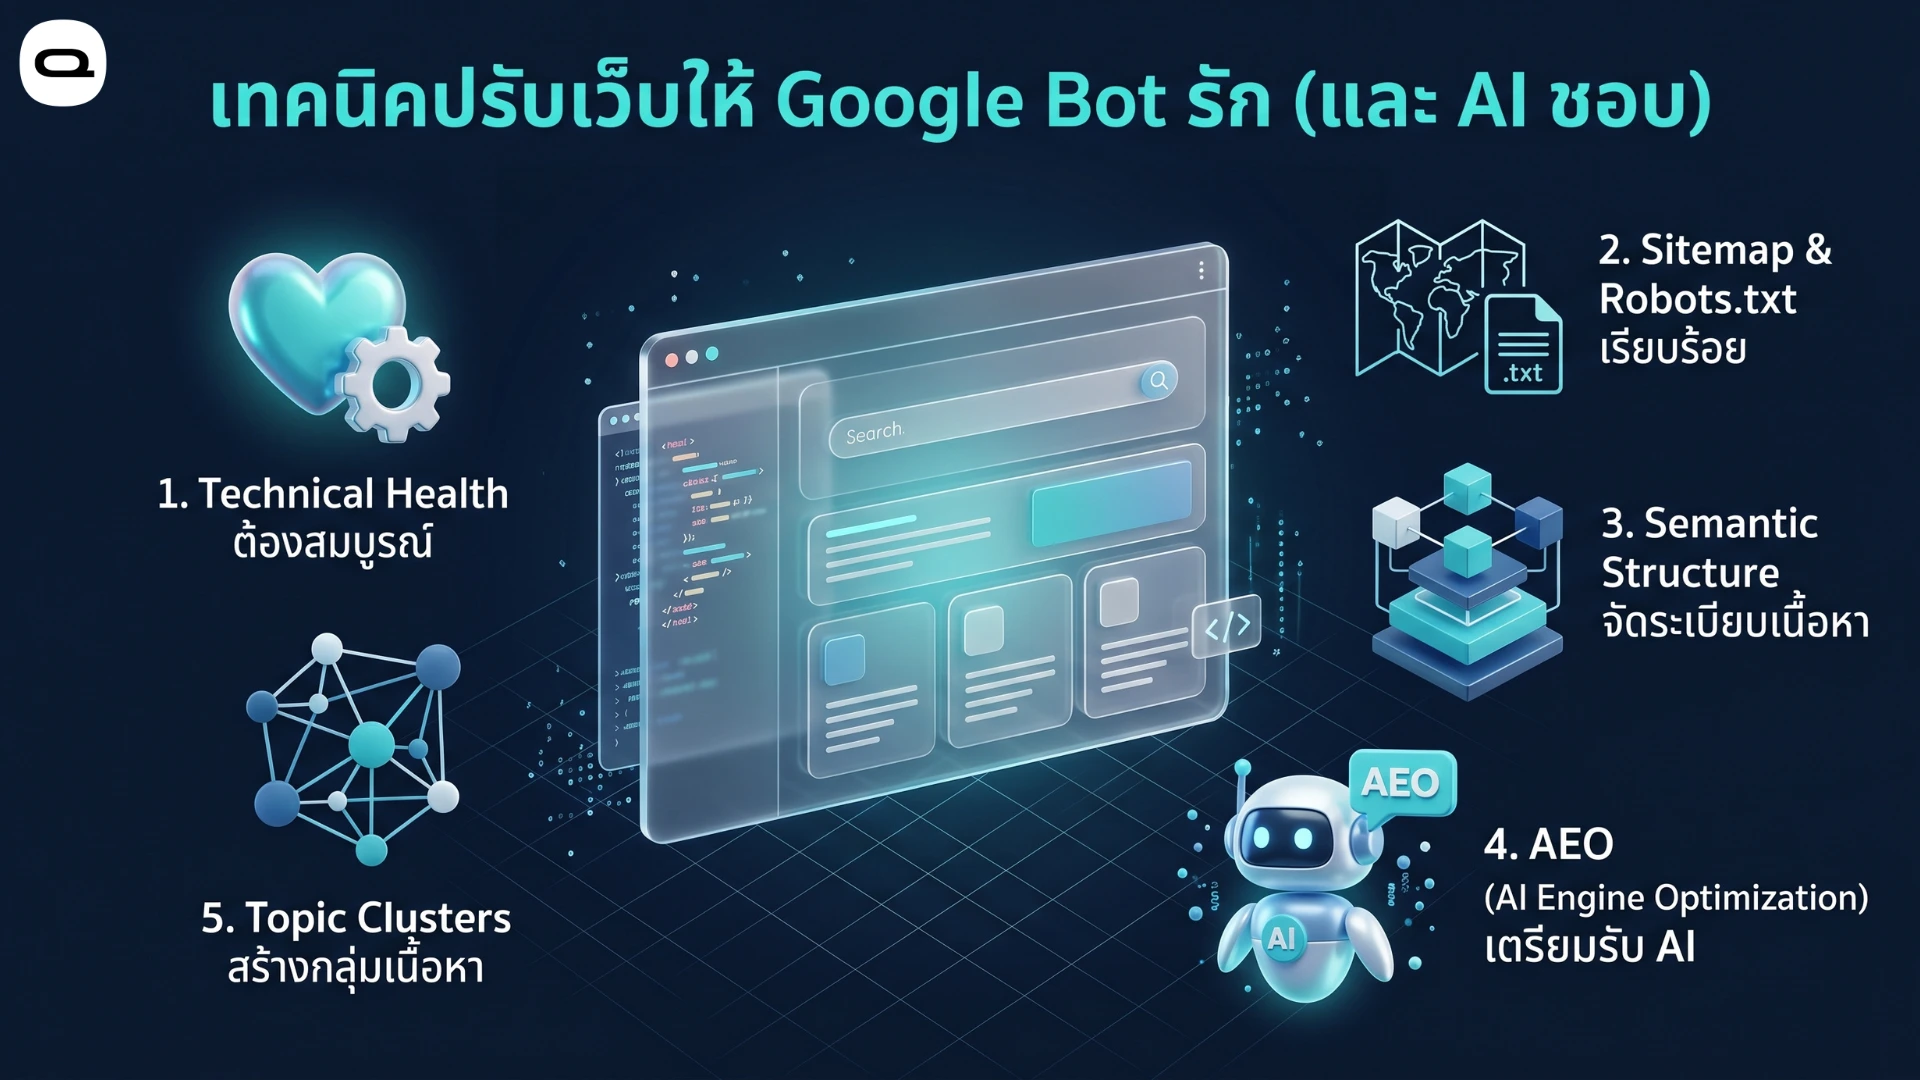
พ่อใหญ่รวบรวมเทคนิคที่ผ่านการพิสูจน์แล้วว่าได้ผลจริงในปี 2026 มาให้หลานครบทุกมิติ
Technical Health ต้องสมบูรณ์
รากฐานทุกอย่างเริ่มจากสุขภาพเชิงเทคนิคของเว็บ อย่าปล่อยให้มีลิงก์เสีย (Broken Links/404) เยอะ เพราะมันทำให้ Google Bot เสียเวลา (Waste Crawl Budget) โดยเปล่าประโยชน์ นอกจากนี้ต้องมั่นใจว่าเว็บโหลดเร็ว ค่า Core Web Vitals ผ่านเกณฑ์ทั้ง 3 ตัวชี้วัด ได้แก่ LCP ต่ำกว่า 2.5 วินาที, INP ต่ำกว่า 200ms และ CLS ต่ำกว่า 0.1
การทำ HTTPS ก็เป็นสิ่งที่ขาดไม่ได้ Google ยืนยันแล้วว่า HTTPS เป็น Ranking Signal และบอทจะให้ความสำคัญกับเว็บที่ปลอดภัยมากกว่า นอกจากนี้ถ้าเว็บใช้ Redirects เยอะ ต้องตรวจสอบว่าไม่มี Redirect Chains ยาว ๆ ที่ทำให้บอทเสีย Hop มากเกินไป
Sitemap และ Robots.txt ต้องแม่นยำ
ตรวจสอบให้แน่ใจว่า XML Sitemap อัปเดตอัตโนมัติทุกครั้งที่มีเนื้อหาใหม่ และ Submit ไว้ใน Google Search Console เสมอ Sitemap เป็นเหมือน “ลายแทง” ที่บอกบอทว่าเว็บคุณมีหน้าอะไรบ้าง หน้าไหนสำคัญ หน้าไหนเพิ่งอัปเดต ส่วน Robots.txt ต้องตั้งค่าอย่างระมัดระวัง ห้ามบล็อก CSS และ JavaScript เพราะบอทต้องใช้ในการ Render หน้าเว็บ
Semantic Structure และ Schema Markup
การจัดโครงสร้างเนื้อหาด้วย Heading Tags ที่ชัดเจน (H1 > H2 > H3) ไม่ได้ช่วยแค่คนอ่าน แต่ช่วยให้บอท “ดึง” ข้อมูลไปสรุปเป็นคำตอบใน AI Search ได้ง่ายขึ้น ยิ่งโครงสร้างดี โอกาสถูก AI หยิบไปตอบยิ่งสูง
การทำ Schema Markup (JSON-LD) ก็เหมือนการ “จัดจาน” อาหารให้บอทกินง่ายที่สุด ถ้าไม่ทำ บอทต้อง “เดา” ว่าเนื้อหาคืออะไร แต่ถ้าทำ บอท “รู้เลย” ว่าข้อมูลนี้เป็น Article, FAQ, How-To หรือ Product แล้วสามารถแสดงผลเป็น Rich Snippets ได้ทันที
AEO กับการเขียนเนื้อหาให้ AI หยิบตอบ
Answer Engine Optimization (AEO) คือเทคนิคการเขียนเนื้อหาให้ AI หยิบไปตอบคำถามได้ง่ายที่สุด หลักการหลักคือ
- ใช้เทคนิค Inverted Pyramid คือเอาคำตอบสรุปขึ้นมาก่อน แล้วค่อยขยายความ
- เขียนประโยคแรกของแต่ละ Section ให้เป็น “คำตอบสำเร็จรูป” ที่ AI ดึงไปใช้ได้ทันที
- ใช้ LSI Keywords และคำที่เกี่ยวข้องเพื่อสร้างความครอบคลุมเชิงความหมาย (Semantic Coverage)
- หลีกเลี่ยงการเขียนแบบ “อ้อมค้อม” หรือ “วนไปวนมา” AI ชอบเนื้อหาที่ตรงประเด็น
Internal Linking แบบ Topic Clusters
การเชื่อมโยงบทความที่เกี่ยวข้องกันเป็นกลุ่มก้อน (Content Hubs) ทำให้ Google Bot เดินสำรวจเว็บคุณได้ทั่วถึงและเข้าใจว่าเว็บเราเชี่ยวชาญเรื่องนั้นจริง ๆ ยกตัวอย่างเช่น บทความเรื่อง Google Bot (หน้านี้) เชื่อมโยงไปยังบทความเรื่อง Crawl Budget, Robots.txt, Technical SEO และอื่น ๆ ที่เกี่ยวข้อง สร้างเป็นโครงข่ายความรู้ที่สมบูรณ์
เคล็ดลับคือ Internal Links ควรใช้ Anchor Text ที่อธิบายเนื้อหาปลายทางได้ชัดเจน ไม่ใช่แค่ “คลิกที่นี่” และควรวาง Link ให้เป็นธรรมชาติ ไม่ใช่ยัดเยียดจน Reader รำคาญ
วิธีตรวจสอบว่า Google Bot เข้าเว็บเราหรือไม่
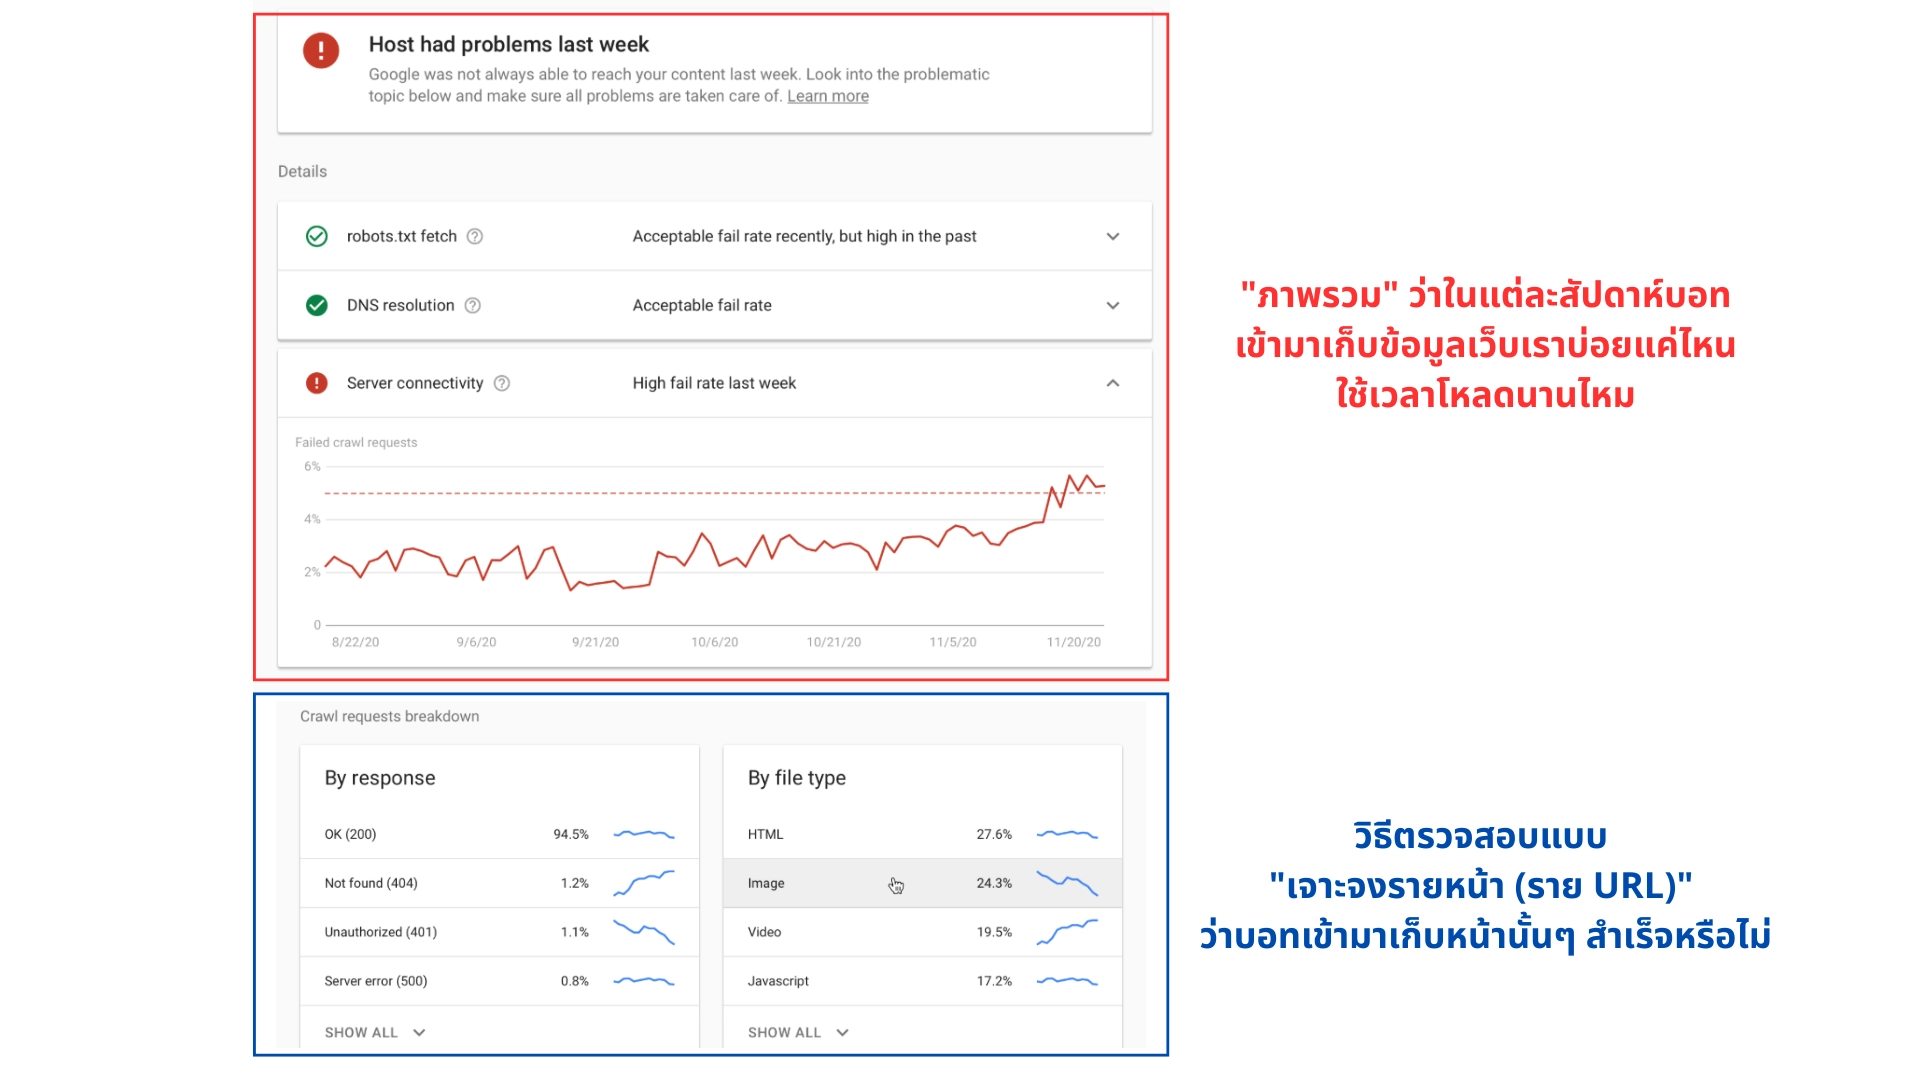
การรู้ว่า Google Bot เข้ามาเว็บเราหรือเปล่า เข้ามาบ่อยแค่ไหน และเจอปัญหาอะไรบ้าง เป็นสิ่งที่คนทำ SEO ต้องตรวจสอบเป็นประจำ พ่อใหญ่รวมวิธีที่ใช้ได้จริงมาให้ครับ
1. Google Search Console (GSC) เป็นเครื่องมือหลักที่ต้องมี เข้าไปที่ส่วน “Crawl Stats” จะเห็นจำนวน Requests ที่บอทส่งมา, ขนาดข้อมูลที่ดาวน์โหลด, เวลาตอบสนองเฉลี่ย และสถานะ HTTP ทั้งหมด ถ้าเห็นว่า Crawl Requests ลดลงกะทันหัน นั่นคือสัญญาณเตือนว่ามีปัญหาบางอย่าง
2. URL Inspection Tool อยู่ใน GSC เช่นกัน ใช้ตรวจสอบหน้าเว็บเฉพาะหน้าว่าบอทเข้าถึงได้หรือไม่ Render สำเร็จหรือเปล่า และ Index แล้วหรือยัง ฟีเจอร์ “Live Test” จะแสดง Screenshot ที่บอทเห็น ถ้า Screenshot แสดงหน้าว่างหรือไม่ครบ แสดงว่ามีปัญหาเรื่อง JavaScript Rendering
3. Server Logs Analysis สำหรับคนที่ต้องการข้อมูลเชิงลึก การวิเคราะห์ Server Access Logs จะเห็นว่าบอทตัวไหนเข้ามาเมื่อไร เข้าหน้าไหน และได้รับ Status Code อะไร วิธีนี้ช่วยให้เข้าใจพฤติกรรมจริง ๆ ของบอท ไม่ใช่แค่ข้อมูลที่ GSC สรุปมาให้
4. Request Indexing ถ้าต้องการ “กระตุ้น” ให้บอทมาเก็บหน้าใหม่ ให้เข้าไปที่ URL Inspection Tool แล้วกดปุ่ม “Request Indexing” แต่มีข้อจำกัดว่ากดได้ไม่เกิน 10-12 ครั้งต่อวัน วิธีที่ยั่งยืนกว่าคือสร้าง Internal Link จากหน้าเก่าที่มี Traffic ดี ๆ ส่งลิงก์มาหาหน้าใหม่ บอทจะเดินตามลิงก์มาเอง
10 ข้อผิดพลาดที่ทำให้ Google Bot ไม่เก็บเว็บคุณ
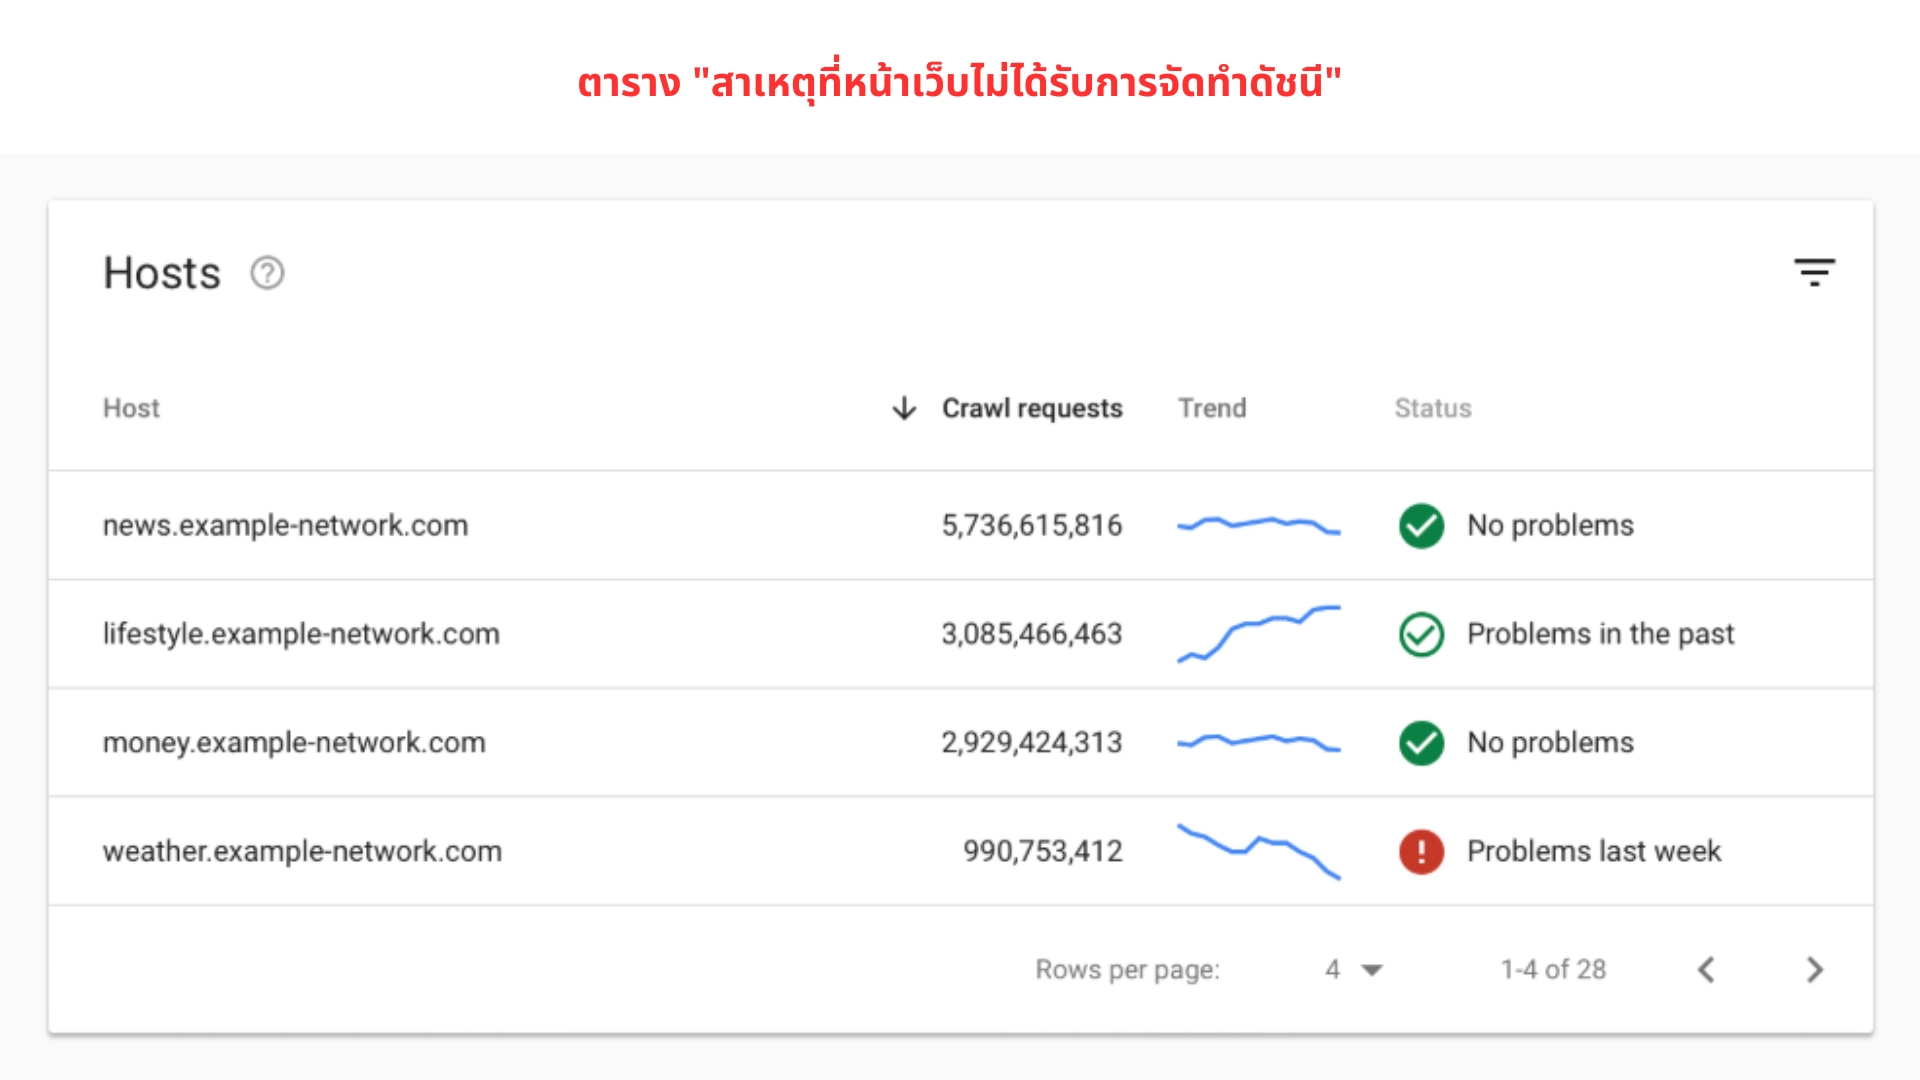
พ่อใหญ่เห็นข้อผิดพลาดเหล่านี้ซ้ำแล้วซ้ำเล่าในเว็บไซต์ที่มาขอคำปรึกษา ลองเช็คดูว่าเว็บหลานติดข้อไหนบ้าง
| ลำดับ | ข้อผิดพลาด | ผลกระทบ | วิธีแก้ไข |
|---|---|---|---|
| 1 | Robots.txt บล็อกหน้าสำคัญ | บอทเข้าไม่ได้เลย | ตรวจสอบ Robots.txt ทุกครั้งหลังอัปเดตเว็บ |
| 2 | Server ตอบช้าหรือ Error 5xx | บอทลดความถี่ในการ Crawl | ลงทุน Hosting ดี ๆ และ Monitor Uptime |
| 3 | JavaScript Rendering ล้มเหลว | บอทเห็นหน้าว่าง | ทำ SSR หรือ Dynamic Rendering |
| 4 | ไม่มี XML Sitemap หรือ Sitemap ล้าสมัย | บอทหาหน้าใหม่ไม่เจอ | ตั้งค่า Auto-Generate Sitemap + Submit GSC |
| 5 | Broken Links (404) จำนวนมาก | เสียเปล่า Crawl Budget | Scan ลิงก์เสียประจำ + ทำ 301 Redirect |
| 6 | Duplicate Content ไม่จัดการ | บอทสับสน เลือก Index ผิดหน้า | ใช้ Canonical Tags อย่างถูกต้อง |
| 7 | Redirect Chains ยาวเกินไป | บอทเสีย Hop และ PageRank ระหว่างทาง | ลด Chain ให้เหลือ 1 Hop (ตรงไปตรงมา) |
| 8 | เนื้อหาบาง (Thin Content) | ถูก Crawl แต่ไม่ถูก Index | เขียนเนื้อหาให้ลึกและครอบคลุม ตาม E-E-A-T |
| 9 | ไม่มี Internal Links ชี้มา | หน้าเป็น Orphan Page บอทหาไม่เจอ | สร้าง Internal Links จากหน้าที่เกี่ยวข้อง |
| 10 | ใช้ noindex โดยไม่ตั้งใจ | บอทเข้าได้แต่ไม่จัดเก็บ | ตรวจ Meta Robots Tag ใน Meta Tags |
ข้อผิดพลาดเหล่านี้อาจดูเป็นเรื่องเล็กน้อยทีละข้อ แต่ถ้าเจอหลายข้อพร้อมกัน ผลกระทบจะทบทวีคูณ เว็บที่มี Technical Issues สะสมเยอะ ๆ จะทำให้ Google Bot “เสียความเชื่อมั่น” และลดความถี่ในการมาเยี่ยม ส่งผลให้เนื้อหาใหม่ที่คุณเขียนไม่ถูก Index เร็วเท่าที่ควร
เปรียบเทียบ Google Bot กับ AI Crawlers ตัวอื่น
ในปี 2026 ไม่ได้มีแค่ Google Bot ที่ท่องโลกอินเทอร์เน็ต ยังมี AI Crawlers จากแพลตฟอร์มอื่น ๆ ที่คนทำ SEO ต้องรู้จัก เพราะมันส่งผลต่อ AI Visibility ของแบรนด์คุณในวงกว้าง
| Crawler | เจ้าของ | จุดประสงค์ | ควรเปิดให้เข้าหรือไม่ |
|---|---|---|---|
| Googlebot | Indexing + AI Overviews | ต้องเปิด (ห้ามบล็อก) | |
| GPTBot | OpenAI | เทรน ChatGPT + เก็บข้อมูลสำหรับ ChatGPT Search | แนะนำเปิด (เพิ่ม AI Visibility) |
| ClaudeBot | Anthropic | เก็บข้อมูลสำหรับ Claude AI | แนะนำเปิด |
| PerplexityBot | Perplexity AI | เก็บข้อมูลสำหรับ Perplexity Search | แนะนำเปิด |
| Bingbot | Microsoft | Indexing สำหรับ Bing + Bing Copilot | แนะนำเปิด |
| Google-Extended | เทรน Gemini AI โดยเฉพาะ | เลือกได้ (ไม่กระทบ Index) |
กลยุทธ์ที่พ่อใหญ่แนะนำคือ เปิดให้ AI Crawlers ทุกตัวเข้าถึงเว็บคุณได้ เว้นแต่มีเหตุผลเฉพาะเจาะจงที่ต้องบล็อก เพราะยิ่งเว็บคุณถูก AI หลายแพลตฟอร์มรู้จักมากเท่าไร โอกาสที่แบรนด์คุณจะถูกอ้างอิงเมื่อคนถามคำถามที่เกี่ยวข้องก็ยิ่งสูงขึ้นเท่านั้น นี่คือหัวใจของ Generative Engine Optimization (GEO) ในยุคนี้
PRO TIP กับดัก Zero-Click Search ที่ต้องรู้ทัน
การที่ Google Bot รักเราและเอาข้อมูลไปแสดงบน AI Overview เป็นเรื่องดี แต่มี “ดาบสองคม” ที่ต้องระวัง คือ User อาจจะอ่านจบที่หน้า Google แล้วไม่คลิกเข้าเว็บเรา (Zero-Click Search) จากข้อมูลล่าสุดในปี 2026 พบว่ามากกว่า 60% ของการค้นหาทั้งหมดจบลงโดยไม่มีการคลิกเข้าเว็บใด ๆ
วิธีรับมือกับปัญหานี้คือ อย่าเขียนแค่ข้อมูลทั่วไป (Basic Info) ที่ AI สรุปแทนได้ แต่ให้เน้นเขียน “Experience and Insight” ประสบการณ์จริงและความเห็นเชิงลึกที่หาที่ไหนไม่ได้ เพื่อดึงดูดให้คนต้องคลิกเข้ามาอ่านของจริงที่เว็บเรา
ยกตัวอย่างเช่น แทนที่จะเขียนว่า “Google Bot คือซอฟต์แวร์ที่ Crawl เว็บ” (AI สรุปเองได้) ให้เขียนว่า “จากประสบการณ์ที่ทำ SEO มากว่า 10 ปี พ่อใหญ่เห็นว่าเว็บที่ Server Response ต่ำกว่า 200ms จะได้ Crawl Budget เพิ่มขึ้น 30-40% เมื่อเทียบกับเว็บที่ตอบช้ากว่า 1 วินาที” ข้อมูลแบบนี้ AI ไม่สามารถสร้างเองได้ คนจึงต้องคลิกเข้ามาอ่าน
นอกจากนี้ การสร้าง Featured Snippets ที่มีข้อมูลเชิญชวนให้คลิกต่อ (Teaser Content) ก็เป็นเทคนิคที่ได้ผล ให้ข้อมูลที่เป็นประโยชน์พอให้ AI หยิบไปแสดง แต่ทิ้ง “ของดี” ไว้ในเว็บเพื่อให้คนต้องคลิกเข้ามาอ่านเพิ่ม
Checklist เตรียมเว็บให้ Google Bot รัก (2026)
เช็คว่าเว็บหลานพร้อมให้ Google Bot และ AI Crawler เข้าถึงหรือยังครับ
Checklist ด้าน Technical
✅ ตรวจ robots.txt ไม่บล็อก Googlebot, Googlebot-Image, Google-Extended
✅ ไม่บล็อก AI Crawlers ที่ต้องการ ได้แก่ GPTBot, ClaudeBot, PerplexityBot
✅ มี XML Sitemap อัปเดตล่าสุด + submit ใน Google Search Console แล้ว
✅ ตรวจ Crawl Errors ใน GSC ไม่มี 404/5xx ที่สำคัญค้างอยู่
✅ จัดการ Crawl Budget อย่างมีประสิทธิภาพ (noindex หน้าที่ไม่ต้องการ Index)
✅ เว็บ Render ได้ถูกต้อง ไม่มี JavaScript บล็อกเนื้อหาสำคัญ
✅ ใช้ Canonical Tags ป้องกัน Duplicate Content อย่างถูกต้อง
✅ เว็บโหลดเร็ว Core Web Vitals ผ่านเกณฑ์ (LCP < 2.5s, INP < 200ms, CLS < 0.1)
Checklist ด้าน Content และ Structure
✅ ใช้ Heading Tags (H1-H6) จัดลำดับชั้นอย่างชัดเจน
✅ มี Schema Markup (JSON-LD) สำหรับประเภทเนื้อหาหลัก
✅ เขียนเนื้อหาแบบ Inverted Pyramid เอาคำตอบขึ้นก่อน
✅ มี Internal Links เชื่อมโยงบทความที่เกี่ยวข้องเป็น Topic Clusters
✅ รูปภาพทุกรูปมี Alt Text ที่อธิบายเนื้อหาได้ชัดเจน
✅ ไม่มี Thin Content ทุกหน้ามีเนื้อหาลึกพอที่ Google จะ Index
บทสรุป Google Bot ในยุค AI Search 2026
สุดท้าย พ่อใหญ่ฝากบอกว่า ในปี 2026 Google Bot ไม่ใช่แค่เครื่องจักรเก็บคำค้นหาแบบเดิมอีกต่อไป มันคือนักสำรวจข้อมูลอัจฉริยะที่ทำงานคู่ขนานไปกับ AI อย่าง Gemini หากคุณเข้าใจการทำงานของมัน ทั้งด้านความเร็ว (Technical), บริบทและเอนทิตี (Context/Entity) และโครงสร้าง (Structure) เว็บไซต์ของคุณจะไม่ใช่แค่ “ติดอันดับ” ในผลการค้นหาแบบเดิม แต่จะกลายเป็น “คำตอบที่ใช่” ในยุคของ AI Search อีกด้วย
สิ่งที่ต้องจำไปตลอดคือ Technical SEO เป็นรากฐานของทุกอย่าง ถ้าบอทเข้าเว็บคุณไม่ได้ ทุกความพยายามด้าน Content, On-Page SEO และ Backlinks ก็สูญเปล่า เริ่มจากจัดการ Technical ให้เป๊ะก่อน แล้วค่อยต่อยอดเรื่อง Content และ Authority ทีหลัง
ถ้าหลานอยากเรียนรู้เพิ่มเติมเกี่ยวกับ SEO ตั้งแต่พื้นฐานจนถึงระดับสูง พ่อใหญ่รวบรวมไว้ให้ครบในซีรีส์ คู่มือ SEO สำหรับมือใหม่ ลองไปอ่านต่อได้ครับ
ต้องการให้ผู้เชี่ยวชาญช่วยวางกลยุทธ์ SEO?
ปรึกษาพ่อใหญ่ฟรี วิเคราะห์เว็บไซต์ พร้อมแนะนำแผนที่เหมาะกับธุรกิจคุณ
บทความในกลุ่ม SEO Basics
บทความนี้เป็นส่วนหนึ่งของซีรีส์ SEO Basics ทั้ง 11 เรื่องที่พ่อใหญ่รวบรวมไว้ให้ครบ ตั้งแต่พื้นฐานจนถึงการลงมือทำจริง
FAQ คำถามคาใจเรื่อง Google Bot 2026
เลิกโทษดวงครับ! ถ้าบอทไม่เก็บ (Index) มีอยู่ 2 สาเหตุหลัก สาเหตุแรกคือ Technical ห่วย คุณอาจเผลอไปบล็อกบอทใน Robots.txt หรือหน้าเว็บโหลดช้าจนบอท “ถอดใจ” (Time out) ก่อนเก็บข้อมูลเสร็จ สาเหตุที่สองคือ Quality ต่ำ เนื้อหาซ้ำซาก (Duplicate) หรือเขียนไม่มีแก่นสาร Google Bot ปี 2026 ฉลาดพอที่จะไม่เก็บ “ขยะ” เข้าบ้านครับ ลองเข้า Google Search Console ดูที่ส่วน URL Inspection แล้วเช็คว่าหน้านั้นมีปัญหาอะไร
อย่าหาทำไปบล็อกมันเชียวนะ! GoogleOther ไม่ใช่ไวรัส แต่คือบอทที่ Google ใช้เก็บข้อมูลไปเทรนโมเดล AI (Gemini) หรือทำงานวิจัย (R&D) ถ้าเจอตัวนี้เข้ามาเยอะ แปลว่าเว็บคุณมีข้อมูลที่มีค่าพอที่ AI อยากเรียนรู้ ถือเป็นข่าวดีครับ! นอกจากนี้ยังมี Google-Extended ที่ทำหน้าที่คล้ายกัน แต่เน้นเก็บข้อมูลเพื่อปรับปรุง Gemini โดยเฉพาะ ซึ่งคุณเลือกบล็อกได้โดยไม่กระทบ Indexing ปกติ
ถามกลับนะ… ถ้ามีอาหารอร่อยแต่เทกองบนโต๊ะ กับจัดใส่จานพร้อมช้อนส้อม คุณจะเลือกกินอันไหน? Schema Markup คือการ “จัดจาน” ให้บอทกินง่ายที่สุด ถ้าคุณไม่ทำ บอทต้อง “เดา” ว่าเนื้อหาคืออะไร แต่ถ้าทำ บอท “รู้เลย” และเอาไปแสดงผลสวย ๆ ใน Rich Snippets และ AI Search ได้ทันที ยิ่งในปี 2026 ที่ AI ต้องดึงข้อมูลจากหลายแหล่งมาประมวลผล ใครมี Structured Data ครบก็ได้เปรียบ จบนะ
ขึ้นได้… แต่อาจจะ “หอบ” หน่อย ถ้าเว็บคุณใช้ JavaScript Framework หนัก ๆ (พวก React, Vue, Angular) แล้วให้บอทมารอ Render เอง (Client-Side) คุณกำลังเสี่ยงดวงกับ Crawl Budget ถ้าบอทอารมณ์ดีมันก็รอ ถ้ามันรีบมันก็ไป การทำ SSR หรือ Dynamic Rendering คือการการันตีว่าบอทจะได้เนื้อหาครบ 100% ทันทีที่เข้าเว็บ เป็น Logic ความปลอดภัยล้วน ๆ ถ้างบไม่ถึง SSR ลองดู Pre-rendering เป็นทางเลือกก็ได้ครับ
มี! เข้าไปที่ Google Search Console แล้วกดใช้ฟีเจอร์ “Request Indexing” ซะ แต่มันมีโควต้านะครับ กดรัวไม่ได้ (ประมาณ 10-12 ครั้งต่อวัน) วิธีที่ยั่งยืนกว่าคือ “สร้าง Internal Link” จากหน้าเก่าที่มี Traffic ดี ๆ ส่งลิงก์มาหาหน้าใหม่ บอทมันจะเดินตามลิงก์มาเอง นอกจากนี้ การ Ping Sitemap ผ่าน GSC หลังอัปเดตเนื้อหาใหม่ก็ช่วยเร่งให้บอทรู้ว่ามีอะไรเปลี่ยนแปลง นี่คือวิธีเรียกแขกแบบธรรมชาติและได้ผลที่สุดครับ
ต่างกันครับ! Googlebot (ตัวหลัก) จะ Crawl เนื้อหา HTML ทั้งหมดของหน้าเว็บ ส่วน Googlebot-Image จะ Crawl เฉพาะไฟล์รูปภาพเพื่อนำไปแสดงใน Google Images ถ้าคุณบล็อก Googlebot-Image ใน Robots.txt รูปภาพของคุณจะไม่ปรากฏในผลการค้นหารูปภาพเลย แต่เนื้อหา Text ยังถูก Index ปกติ คำแนะนำคืออย่าบล็อกทั้งสองตัว เพราะรูปภาพที่ปรากฏใน Google Images เป็นแหล่ง Traffic ฟรีที่หลายคนมองข้าม
พูดตรง ๆ ว่าเว็บที่มีต่ำกว่า 1,000 หน้า Crawl Budget มักไม่ใช่ปัญหาใหญ่ เพราะ Google Bot สามารถ Crawl ครบทุกหน้าได้ภายในเวลาไม่นาน แต่! ถ้าเว็บเล็กแต่มีปัญหา Technical เยอะ เช่น Broken Links เป็นร้อย, Redirect Chains ยาว ๆ หรือ Server ตอบช้า บอทก็อาจเสียเวลากับหน้าที่ไม่สำคัญจนหน้าสำคัญไม่ได้ Crawl ทัน สำหรับเว็บ E-commerce หรือเว็บข่าวที่มีหลายหมื่นหลายแสนหน้า Crawl Budget เป็นเรื่องวิกฤตที่ต้องจัดการอย่างจริงจัง
สถานะนี้หมายความว่า Google Bot รู้ว่าหน้านี้มีอยู่ (Discovered) แต่ยังไม่ได้ไป Crawl จริง ๆ สาเหตุหลัก ๆ ก็คือ บอทจัดลำดับความสำคัญหน้านี้ต่ำกว่าหน้าอื่น อาจเป็นเพราะหน้านี้ไม่มี Internal Links ชี้มามากพอ, เนื้อหาคล้ายกับหน้าอื่นที่มีอยู่แล้ว หรือ Server ตอบช้าจนบอทยังไม่มีโอกาสมา วิธีแก้คือ เพิ่ม Internal Links จากหน้าที่มี Authority สูงชี้มา, ปรับปรุงเนื้อหาให้มีคุณค่ามากขึ้น และตรวจสอบว่า Server Response Time ดี
คำแนะนำของพ่อใหญ่คือ เปิดให้หมดเลยครับ! ในยุคที่ AI Search กำลังเติบโตอย่างรวดเร็ว การเปิดให้ GPTBot, ClaudeBot, PerplexityBot และ Bingbot เข้าถึงเนื้อหาของคุณได้ จะเพิ่มโอกาสให้แบรนด์คุณถูกอ้างอิงเมื่อคนถามคำถามที่เกี่ยวข้องกับธุรกิจคุณ นี่คือหัวใจของ Generative Engine Optimization (GEO) ข้อยกเว้นเดียวคือถ้าคุณมีเนื้อหาที่เป็น Premium/Paywall คุณอาจต้องพิจารณาบล็อก AI Training Crawlers เพื่อปกป้องมูลค่าเนื้อหา แต่สำหรับเว็บทั่วไป เปิดให้หมดดีกว่าครับ
แหล่งอ้างอิง (References)
Google (2026). “Google Crawlers and Fetchers (User Agents)” developers.google.com
Google (2026). “How Google Search Works” developers.google.com
Google (2025). “Large Site Owner’s Guide to Managing Your Crawl Budget” developers.google.com
Google (2025). “Introduction to Robots.txt” developers.google.com
Google (2026). “Google-Extended Documentation” developers.google.com
Google (2026). “AI Overviews and Your Website” support.google.com
Web Almanac by HTTP Archive (2025). “SEO Chapter – Crawlability and Indexability” almanac.httparchive.org
เขียนโดย BIQDADDY
อ่านอะไรต่อดี?